Pourquoi Facebook a réinventé l'API — et ce que ça change pour toi
REST fonctionnait. Mais Facebook avait un problème : trop de requêtes, trop de données inutiles. Alors ils ont créé GraphQL — une façon de demander exactement ce dont on a besoin, rien de plus.
Qu'est-ce que GraphQL ? Pourquoi Facebook l'a créé et comment il fonctionne
Introduction
Aujourd'hui, lorsqu'on développe une application web ou mobile, il est très courant de communiquer avec un serveur via une API REST. Pendant de nombreuses années, cette approche a été la norme et reste encore largement utilisée.
Pourtant, en 2012, Facebook s'est retrouvé confronté à plusieurs limites lors du développement de ses applications mobiles. Les connexions réseau étaient parfois lentes, les appareils moins puissants qu'aujourd'hui et certaines pages nécessitaient de nombreuses requêtes pour récupérer toutes les données nécessaires.
C'est dans ce contexte que Facebook a commencé à développer GraphQL, une technologie qui sera ensuite publiée en open source en 2015.
Mais pourquoi créer une nouvelle façon de communiquer avec une API alors que REST fonctionnait déjà très bien ?
Les limites rencontrées avec REST
Imaginons que tu souhaites afficher le profil d'un utilisateur sur un réseau social.
Tu as besoin de récupérer :
Son nom, sa photo de profil, ses trois derniers posts, sa liste d'amis
Avec une API REST classique, il est fréquent de devoir interroger plusieurs endpoints :
GET /users/1
GET /users/1/posts
GET /users/1/friends
GET /users/1/avatar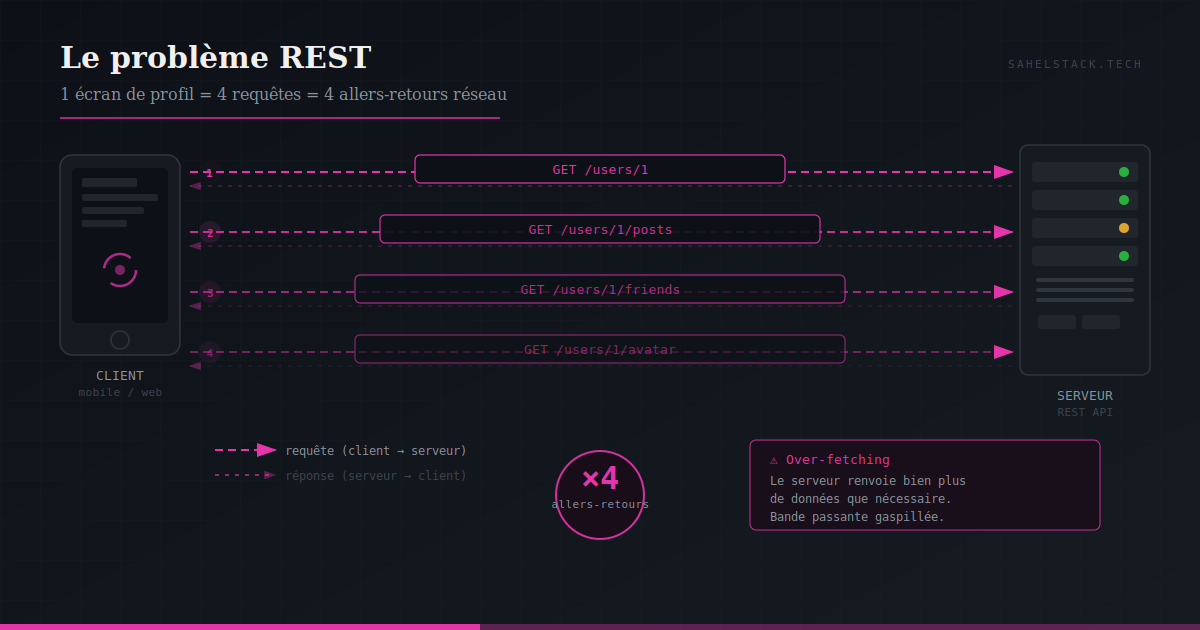
Chaque requête implique un aller-retour entre le client et le serveur.
Lorsque les données deviennent plus complexes, le nombre de requêtes peut rapidement augmenter, ce qui impacte les performances, notamment sur les appareils mobiles.
Deux problèmes apparaissent alors fréquemment.
L'over-fetching
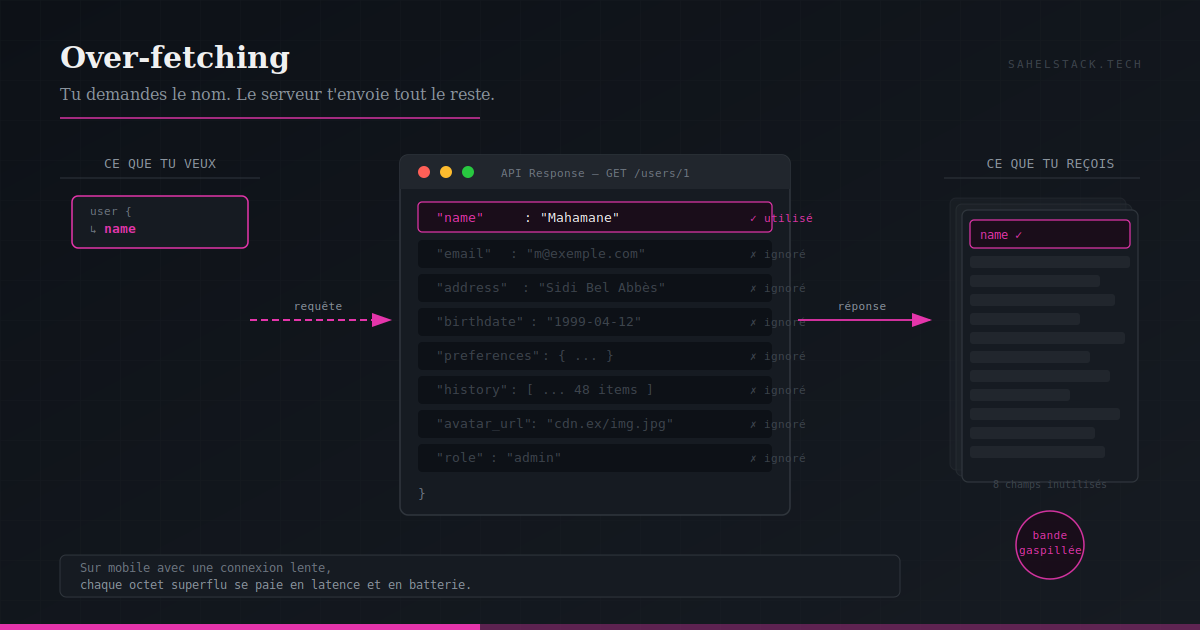
L'over-fetching se produit lorsque le serveur renvoie davantage de données que nécessaire.
Par exemple, tu souhaites uniquement récupérer le nom d'un utilisateur.
Pourtant, l'API renvoie également :
Son email, son adresse, sa date de naissance, ses préférences, son historique d'activité
Tu récupères donc beaucoup d'informations inutiles, ce qui augmente la taille des réponses et consomme davantage de bande passante.
L'under-fetching
L'under-fetching est le problème inverse.
Cette fois, la réponse ne contient pas suffisamment d'informations pour construire l'écran souhaité.
Tu es alors obligé d'effectuer plusieurs requêtes supplémentaires afin d'obtenir les données manquantes.
La solution proposée par GraphQL
Pour répondre à ces problèmes, Facebook a créé GraphQL.
L'idée est simple :
Le client demande exactement les données dont il a besoin, et le serveur renvoie exactement ces données.
Au lieu d'utiliser plusieurs endpoints différents, GraphQL expose généralement un seul endpoint.
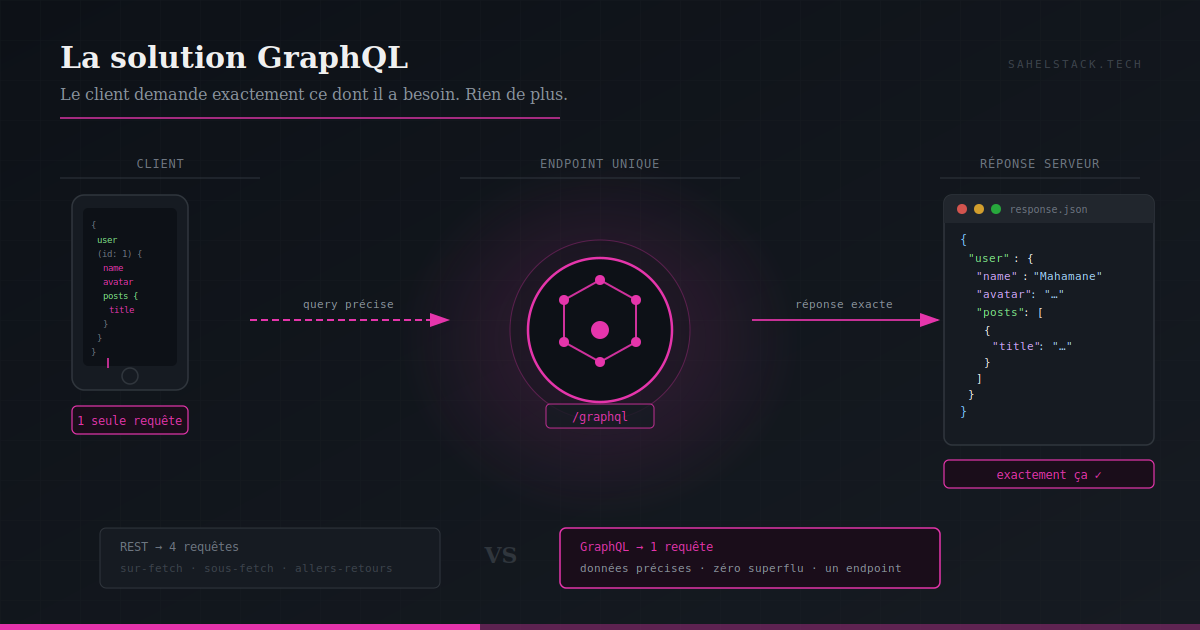
Le client décrit précisément les informations souhaitées.
Par exemple :
query {
  user(id: 1) {
    name
    avatar
    posts(limit: 3) {
      title
    }
  }
}
Le serveur répond alors uniquement avec les données demandées :
{
  "data": {
    "user": {
      "name": "Mahamane",
      "avatar": "avatar.jpg",
      "posts": [
        {
          "title": "Mon premier post"
        },
        {
          "title": "GraphQL expliqué simplement"
        }
      ]
    }
  }
}
Aucune donnée inutile.
Aucune information manquante.
Le client contrôle précisément ce qu'il reçoit.
Comment fonctionne GraphQL ?
GraphQL repose sur plusieurs concepts fondamentaux.
Le Schema
Le Schema définit les données disponibles ainsi que leurs relations.
Il représente le contrat entre le client et le serveur.
Grâce au Schema, les développeurs savent exactement quelles données peuvent être demandées et quelles opérations sont autorisées.
Exemple :
type User {
  id: ID!
  name: String!
  email: String!
  posts: [Post!]!
}
Les Queries
Les Queries permettent de lire des données.
Elles sont comparables aux requêtes GET dans REST.
Exemple :
query {
  user(id: 1) {
    name
    email
  }
}
Les Mutations
Les Mutations permettent de créer, modifier ou supprimer des données.
Elles sont comparables aux requêtes P OST, PUT, PATCH ou DELETE dans REST.
Exemple :
mutation {
  createUser(name: "Mahamane") {
    id
    name
  }
}
Les Resolvers
Les Resolvers sont les fonctions chargées de récupérer ou de modifier les données demandées par le client.
Lorsqu'une Query ou une Mutation est exécutée, GraphQL appelle les Resolvers correspondants afin de produire la réponse finale.
Ils constituent le lien entre le Schema GraphQL et les différentes sources de données : base de données, API externe, microservice, etc.
Les avantages de GraphQL
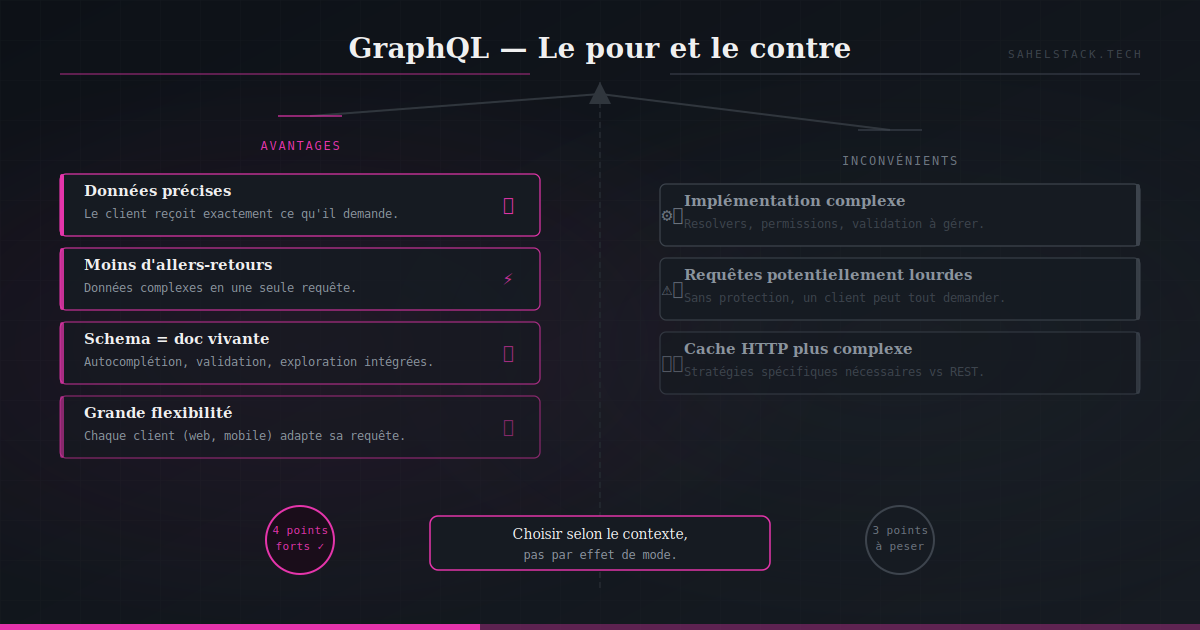
GraphQL présente plusieurs avantages importants.
Une récupération précise des données
Le client choisit exactement les informations dont il a besoin.
Moins d'allers-retours réseau
Certaines données complexes peuvent être récupérées en une seule requête.
Une meilleure expérience développeur
Le Schema sert de documentation vivante.
Les outils modernes peuvent proposer :
De l'autocomplétion
Une validation automatique
L'exploration interactive des données disponibles
Une grande flexibilité
Différents écrans peuvent demander des données différentes sans nécessiter la création de nouveaux endpoints.
Les inconvénients de GraphQL
GraphQL n'est pas une solution magique.
Une implémentation plus complexe
Le backend doit gérer :
Les Resolvers
Les performances
Les autorisations
La validation des requêtes
Des requêtes potentiellement coûteuses
Un client peut demander une très grande quantité de données dans une seule requête.
Sans limitation ou mécanisme de protection, certaines requêtes peuvent devenir très lourdes pour le serveur.
Une mise en cache plus complexe
Le cache HTTP traditionnel est souvent plus simple à mettre en œuvre avec REST.
Des stratégies spécifiques sont généralement nécessaires pour exploiter pleinement le cache avec GraphQL.
Qui utilise GraphQL aujourd'hui ?
Depuis sa création, GraphQL a été adopté par de nombreuses entreprises.
On le retrouve notamment chez :
Meta
GitHub
Shopify
Pinterest
Airbnb
Netflix
Il est particulièrement populaire dans les applications possédant des interfaces riches et des besoins de données complexes.
Faut-il utiliser GraphQL ?
Pour une API simple, REST reste souvent une excellente solution.
En revanche, lorsque plusieurs clients consomment la même API (web, mobile, tablette, objets connectés, etc.) ou que les relations entre les données deviennent complexes, GraphQL peut offrir davantage de flexibilité.
Il permet également d'adapter plus facilement les réponses aux besoins spécifiques de chaque interface.
Le choix dépend donc du contexte, des contraintes techniques et des besoins du projet.
Conclusion
GraphQL est né pour résoudre certaines limites rencontrées par Facebook lors du développement de ses applications mobiles.
Son objectif principal est simple : permettre au client de demander exactement les données dont il a besoin.
Cette approche réduit les problèmes d'over-fetching et d'under-fetching tout en offrant une grande flexibilité aux développeurs.
REST reste aujourd'hui une solution extrêmement pertinente et largement utilisée, mais GraphQL constitue une alternative puissante lorsque les besoins en données deviennent plus complexes ou lorsque plusieurs applications consomment la même API.
Comme souvent en développement logiciel, il n'existe pas de solution universelle : le meilleur choix dépend avant tout du contexte du projet.