On te dit d'utiliser un pool de connexions. J'ai mesuré sur mon Laravel en PHP-FPM : ça ne changerait rien
Tout le monde dit qu'il faut un pool de connexions. Laravel sous PHP-FPM n'en a aucun, et ça tient quand même. J'ai mis ma prod sous charge : le mur n'était ni la base, ni le pool.
Prends n'importe quel article sur les performances backend. À un moment, tu tombes dessus : « n'ouvre pas une connexion à chaque requête, utilise un pool de connexions ». C'est répété partout, et ce n'est pas faux.
Sauf qu'une application Laravel sous PHP-FPM n'a pas de pool de connexions. Pas « un pool mal configuré » : pas de pool du tout, structurellement. Chaque requête ouvre sa connexion à MySQL et la ferme en partant.
Sur mon VPS, ça fait 104 810 connexions ouvertes puis jetées en 22 jours. Et l'application tient sans broncher.
Alors : est-ce que tout le monde a tort, ou est-ce que le conseil ne veut pas dire ce qu'on croit ? J'ai mis ma prod sous charge pour trancher. La réponse ne m'a pas plu. J'avais une théorie élégante, les chiffres l'ont démolie. Puis j'en ai eu une seconde, et les chiffres l'ont démolie aussi.
Une précision avant de commencer, parce qu'elle décide de tout ce qui suit : un benchmark ne répond jamais à une question générale, il répond à une question précise sur une architecture précise. Ici : Laravel sous PHP-FPM, 2 vCPU, MySQL sur la même machine. Change un seul de ces trois paramètres et mes conclusions s'inversent. Je te montre exactement lesquelles, et à quel moment, en section 6.
1. Ce qu'est vraiment un pool de connexions
Avant de dire que PHP n'en a pas, il faut être précis sur ce qu'on cherche.
Ouvrir une connexion à une base de données, ce n'est pas gratuit. Il y a une résolution d'adresse, un handshake TCP, une authentification, une négociation de paramètres. Tout ça avant la moindre requête.
Un pool de connexions fait deux choses, et il faut bien les séparer :
Il borne. Le pool ouvre au maximum N connexions. Au-delà, les requêtes attendent leur tour. La base est protégée de la saturation.
Il réutilise. Une connexion survit à la requête qui l'a empruntée. Elle retourne dans le pool, et la requête suivante la reprend telle quelle, sans repayer le handshake.
C'est la réutilisation qui est le cœur du truc. La borne, c'est du dimensionnement ; la réutilisation, c'est l'optimisation.
Et ce mécanisme existe partout :
Java: HikariCP, le standard de fait.
Go:
database/sqlintègre le pool nativement, tu manipules un pool sans le savoir.Node.js:
pg,mysql2, Prisma. Tous poolent..NET: pooling activé par défaut dans la chaîne de connexion.
Le point commun de ces plateformes : le processus survit à la requête. Un serveur Go ou Node est un processus long-vivant qui traite des milliers de requêtes. Il a un endroit où garder des connexions ouvertes entre deux requêtes : sa propre mémoire.
Retiens cette phrase, c'est toute la suite de l'article.
2. Pourquoi PHP-FPM ne peut pas avoir de pool
PHP-FPM ne fonctionne pas comme ça. Son modèle est le suivant :
Un pool de workers (des processus PHP) attend du travail.
Une requête HTTP arrive, Apache la passe à un worker libre.
Le worker boote l'application entière: autoloader, config, service providers, middleware, routes.
Il traite la requête, renvoie la réponse.
Puis il détruit tout son état. Variables, objets, connexions : rien ne survit.
Il redevient libre, prêt pour la requête suivante, à laquelle il repartira de zéro.
C'est le modèle shared-nothing, et c'est historiquement la grande force de PHP : pas de fuite mémoire qui s'accumule, pas d'état corrompu qui contamine la requête d'après. Chaque requête est vierge.
Mais ça a une conséquence directe : il n'y a aucun endroit où stocker une connexion entre deux requêtes. Le pool applicatif n'est pas absent par négligence, il est impossible par construction. Tu ne peux pas garder une connexion ouverte dans un processus dont tout l'état est rasé à la fin du cycle.
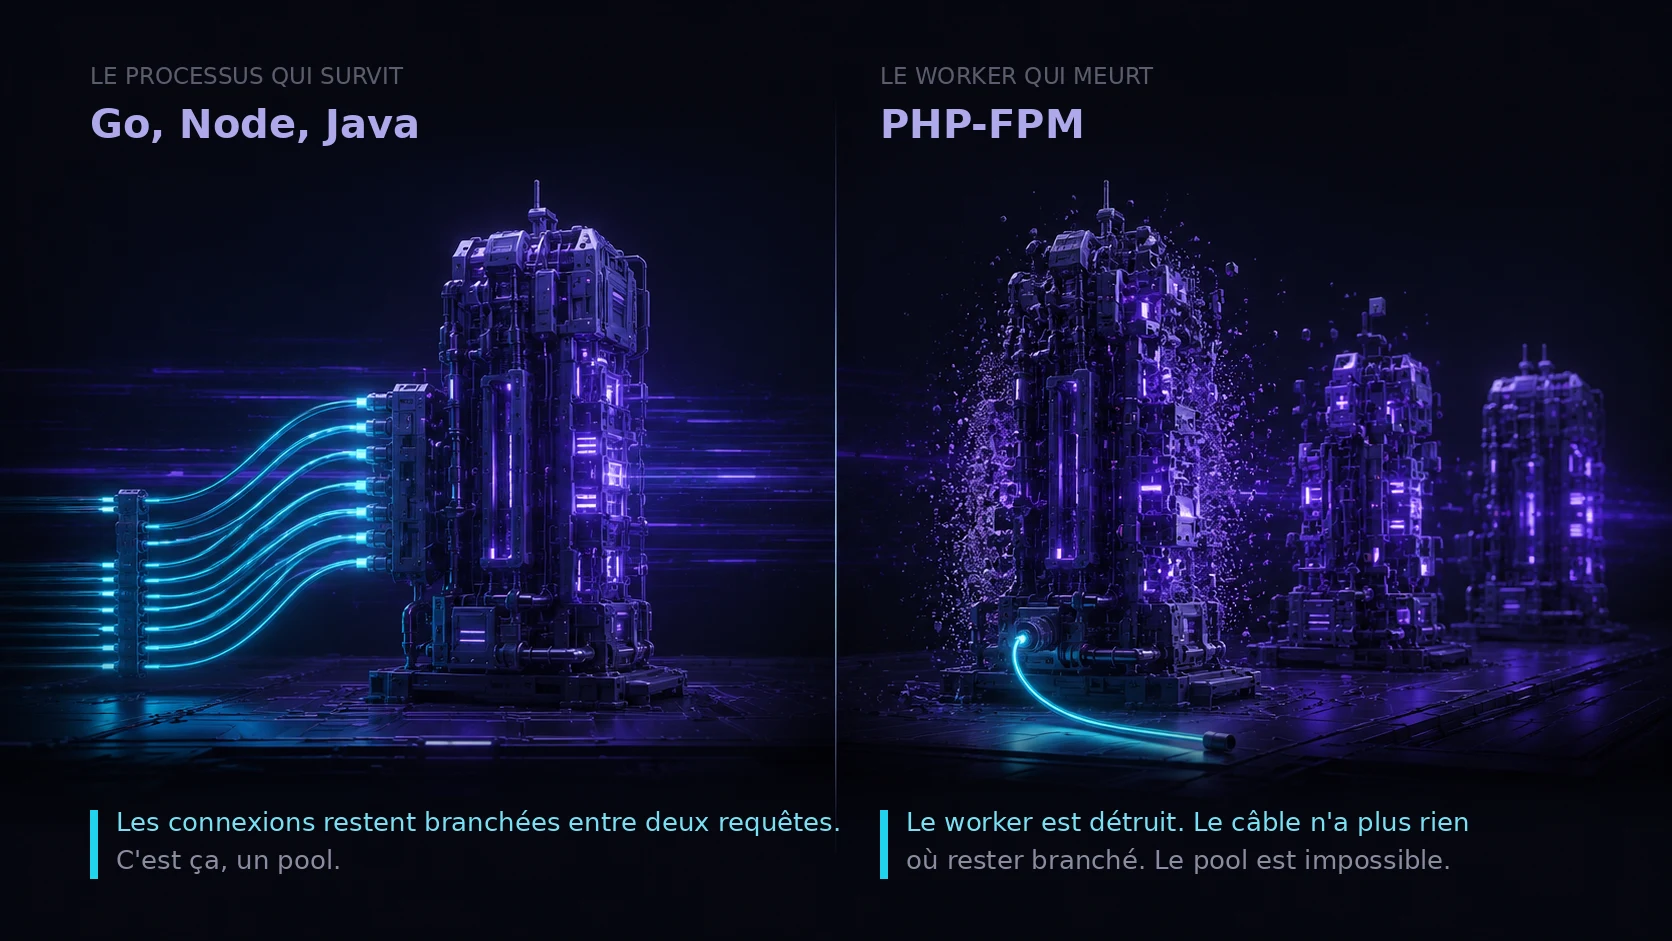
Comparaison des deux modèles d'exécution : à gauche un processus Go ou Node qui survit aux requêtes et garde ses connexions ouvertes en mémoire ; à droite un worker PHP-FPM dont tout l'état est détruit à la fin de chaque requête.
Le pool a besoin d'un endroit où vivre entre deux requêtes. PHP-FPM n'en a aucun.
Donc PHP paie le handshake. À chaque requête. 104 810 fois en 22 jours sur mon serveur.
Et pourtant, ça tient. Il manque une pièce.
3. La réponse que j'ai cru avoir
Voilà mes chiffres MySQL, machine en régime normal, après 22,8 jours d'uptime. Ce sont les valeurs d'avant la mise sous charge de la section 4 : si tu rejoues unSHOW STATUSsur ma machine aujourd'hui, tu verras autre chose, et j'explique pourquoi en section 6.
Métrique | Valeur |
|---|---|
| 104 810 |
| 8 |
| 151 |
| 8 |
| 9 |
Regarde la dernière ligne, c'est troublant. 104 810 connexions, et MySQL n'a créé que 8 threads.
Là, j'ai cru tenir mon histoire. Le pool n'a pas disparu : il a changé d'étage. Il n'est plus dans l'application, il est dans le serveur. C'est le thread cache de MySQL. Quand une connexion se ferme, MySQL ne détruit pas le thread qui la servait, il le garde au chaud pour la prochaine. Sur mes 104 810 connexions, il en a recyclé 104 802.
C'était élégant. PHP jette ses connexions, MySQL récupère derrière, tout le monde est content. Le pooling ne serait pas binaire : il vivrait à plusieurs étages, et en PHP il aurait juste migré côté base.
Sauf que c'est faux. Enfin : c'est vrai, mais ça n'explique rien.
Première fissure, technique : le thread cache économise la création du thread côté serveur. Il n'économise rien du handshake ni de l'authentification, qui sont payés côté client, à chaque fois. Ce n'est donc pas un pool de connexions : il ne fait ni la borne ni la réutilisation de la connexion. Il recycle une ressource interne à MySQL, c'est tout.
Deuxième fissure, plus grosse :Max_used_connections = 8. Mon pic de concurrence historique, sur 22 jours, c'est huit connexions simultanées. Sur un plafond de 151. Autrement dit, ma machine n'a jamais rien fait de difficile. Expliquer que « ça tient » sur une machine qui s'ennuie, ce n'est pas une explication, c'est une tautologie.
Une théorie qui ne tient que sur une machine au repos ne vaut rien. Il fallait la saturer.
4. La mesure
Les chiffres seuls ne prouvent rien. Tout dépend de la manière dont ils ont été obtenus. Voici donc le protocole complet.
Le matériel
VPS 2 vCPU (AMD EPYC 9354P), 8 Go de RAM, Ubuntu 24.04
MySQL 8.0.46, PHP-FPM 8.4, Apache
Cible : une de mes applications Laravel, avec son pool FPM dédié, isolé des autres applications de la machine
Route testée : la racine
/, qui touche réellement la baseOutil :
ab, tiré en local (entrée/etc/hostsvers127.0.0.1, TLS correct, aucun aller-retour internet)Mesuré en parallèle : connexions MySQL (
information_schema.processlist), workers du pool (pgrep), CPU total (delta/proc/stat), CPU consommé parablui-même (/usr/bin/time)
Le biais, tout de suite
abtourne sur la même machine que ce qu'il mesure. Il a consommé ~0,23 cœur pendant les runs. Attention au piège de lecture :/usr/bin/timeaffiche « 23 % », mais c'est 23 % d'un cœur, pas de la machine.abest mono-thread. Sur mes 2 cœurs, ça fait donc ~11,5 % de la capacité totale, pas 23 %.
Recalcul propre : machine à 97 %, dont ~11,5 % pourab. En libérantab, le débit serait multiplié par 97 / 85,5 ≈ 1,13, soit ~145 req/s au lieu des ~127 mesurés.
Mes débits sont donc sous-estimés d'environ 13 %. Ça ne change rien aux conclusions, qui portent toutes sur des comparaisons entre runs affectés du même biais, mais ça doit être dit.
Deuxième règle que je m'impose : je ne compare jamais les chiffres de l'expérience A avec ceux de l'expérience B. Elles n'ont pas le même monitoring (A est plus lourd, donc plus pénalisant). Chaque expérience se lit en interne, et seulement en interne.
Le coût d'une requête, à froid
D'abord, décomposer une requête isolée (concurrence 1, machine au repos, pas de file d'attente) :
Mesure | Temps |
|---|---|
Route | 16 ms (p50 16 / p95 20) |
Route | 10,5 ms (p50 10 / p95 12) |
Ensuite, le handshake, mesuré à part : un script PHP dédié, 3000 itérations, PDO, utilisateur encaching_sha2_password, boucle serrée mono-processus.
Mesure | Temps |
|---|---|
Handshake TCP loopback + auth | 0,34 ms (0,43 ms avec connect + auth + close) |
Handshake socket Unix + auth | 0,21 ms (0,29 ms avec close) |
| 0,09 ms |
| 0,61 ms |
Note sur les deux handshakes : mes 104 810 connexions historiques sont des connexions TCP loopback (DB_HOST=127.0.0.1), à 0,34 ms. J'ai depuis basculé mes applications sur socket Unix, où le handshake tombe à 0,21 ms. Si tu rejoues la mesure sur ma configuration actuelle, c'est 0,21 que tu trouveras. Dans les deux cas la conclusion est identique.
Par soustraction, la décomposition des 16 ms :
Boot de Laravel : ~10,5 ms, soit ~65 %.
Handshake DB : 0,34 ms, soit ~2 %.
Requête SQL réelle : ~0,6 ms. Donc la base de données au total, c'est ~1 ms, soit ~6 %.
Le reste, ~4,5 ms : du PHP. Session, hydratation Eloquent, sérialisation de la réponse.
Premier coup de canif. Le fameux « ouvrir une connexion coûte bien plus cher que la requête » ? Il est vrai contre unSELECT 1: 0,34 contre 0,09 ms, soit ~4×. C'est-à-dire vrai contre une requête qui ne fait rien. Contre une vraie requête applicative, le handshake pèse 2 %. Les deux chiffres sont exacts. C'est pour ça que le débat sur les pools est aussi mal posé : selon ce que tu compares, tu prouves ce que tu veux.
Et le plafond théorique tombe tout seul : 2 vCPU ÷ 16 ms = ~125 req/s.
Expérience A, on monte la concurrence
pm.max_childrenfixé à 20. On fait varier la charge.
Concurrence | RPS | p50 | p95 | p99 | Pic workers |
|
|---|---|---|---|---|---|---|
c=5 | 107 | 44 ms | 70 ms | 105 ms | 5 | 10 |
c=20 | 111 | 165 ms | 331 ms | 451 ms | 19 | 26 |
c=60 | 119 | 482 ms | 723 ms | 798 ms | 20 | 26 |
(Monitoring lourd sur cette expérience : les RPS sont un peu tassés. Comparaison interne uniquement.)
Deux choses sautent aux yeux.
Le débit ne bouge pas. ×12 sur la charge, +12 % sur le débit. Toute la charge supplémentaire ne se transforme pas en travail, elle se transforme en file d'attente. Le p95 est multiplié par 10, de 70 ms à 723 ms. C'est la signature d'une capacité fixe : quand tu envoies plus que la capacité, tu n'obtiens pas plus de débit, tu obtiens de l'attente.
MySQL ne transpire jamais. Le pic de connexions est figé à 26 entre c=20 et c=60. J'ai triplé la charge, le pic MySQL n'a pas bougé d'un pouce. 26 sur un plafond de 151 : 17 %.max_connectionsn'est jamais approché, même de loin, même à saturation.
À ce stade j'ai cru que je tenais la réponse. Encore une fois. Les workers plafonnent à exactement 20 à c=60, soitpm.max_children. Donc le mur, c'est PHP-FPM ! Le pool a été déplacé, il s'appellepm.max_children, il borne (20) mais il ne réutilise pas : la moitié du travail d'un vrai pool.
C'était joli. C'était encore faux.
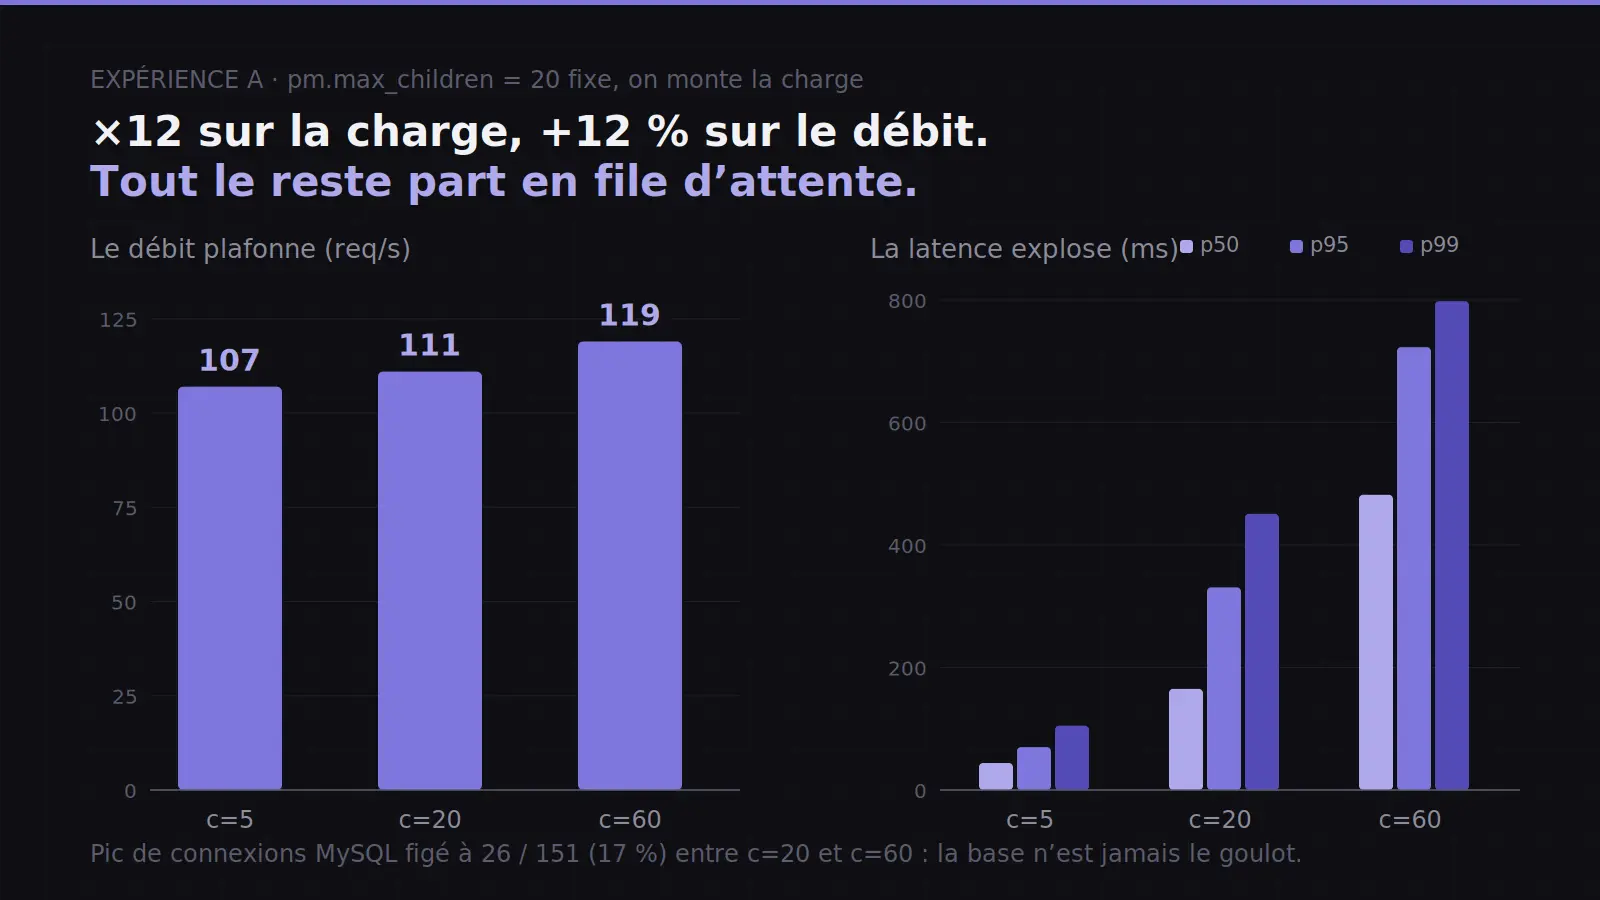
Expérience A : ×12 sur la charge, +12 % sur le débit. Tout le reste part en file d'attente.
Expérience B, le test qui tranche
Parce qu'il y a un problème dans ce raisonnement. Regarde la ligne c=5 de l'expérience A : 107 req/s avec 5 workers. Si le mur était vraimentpm.max_children=20, passer de 5 à 20 workers devrait multiplier le débit par ~4. Il passe à 111. Rien.
Les workers montent à 20/20 parce que les requêtes s'empilent. C'est un symptôme, pas une cause.
Le test décisif : concurrence fixe à 20, et on fait varierpm.max_children.
| RPS | p95 | CPU total | CPU de | Pic workers |
|---|---|---|---|---|---|
8 | 127 | 201 ms | 97 % | 23 % | 8 |
20 | 126 | 206 ms | 98 % | 22 % | 13 |
40 | 131 | 195 ms | 97 % | 23 % | 13 |
Le pool est multiplié par 5. Le débit ne bouge pas : 127, 126, 131.
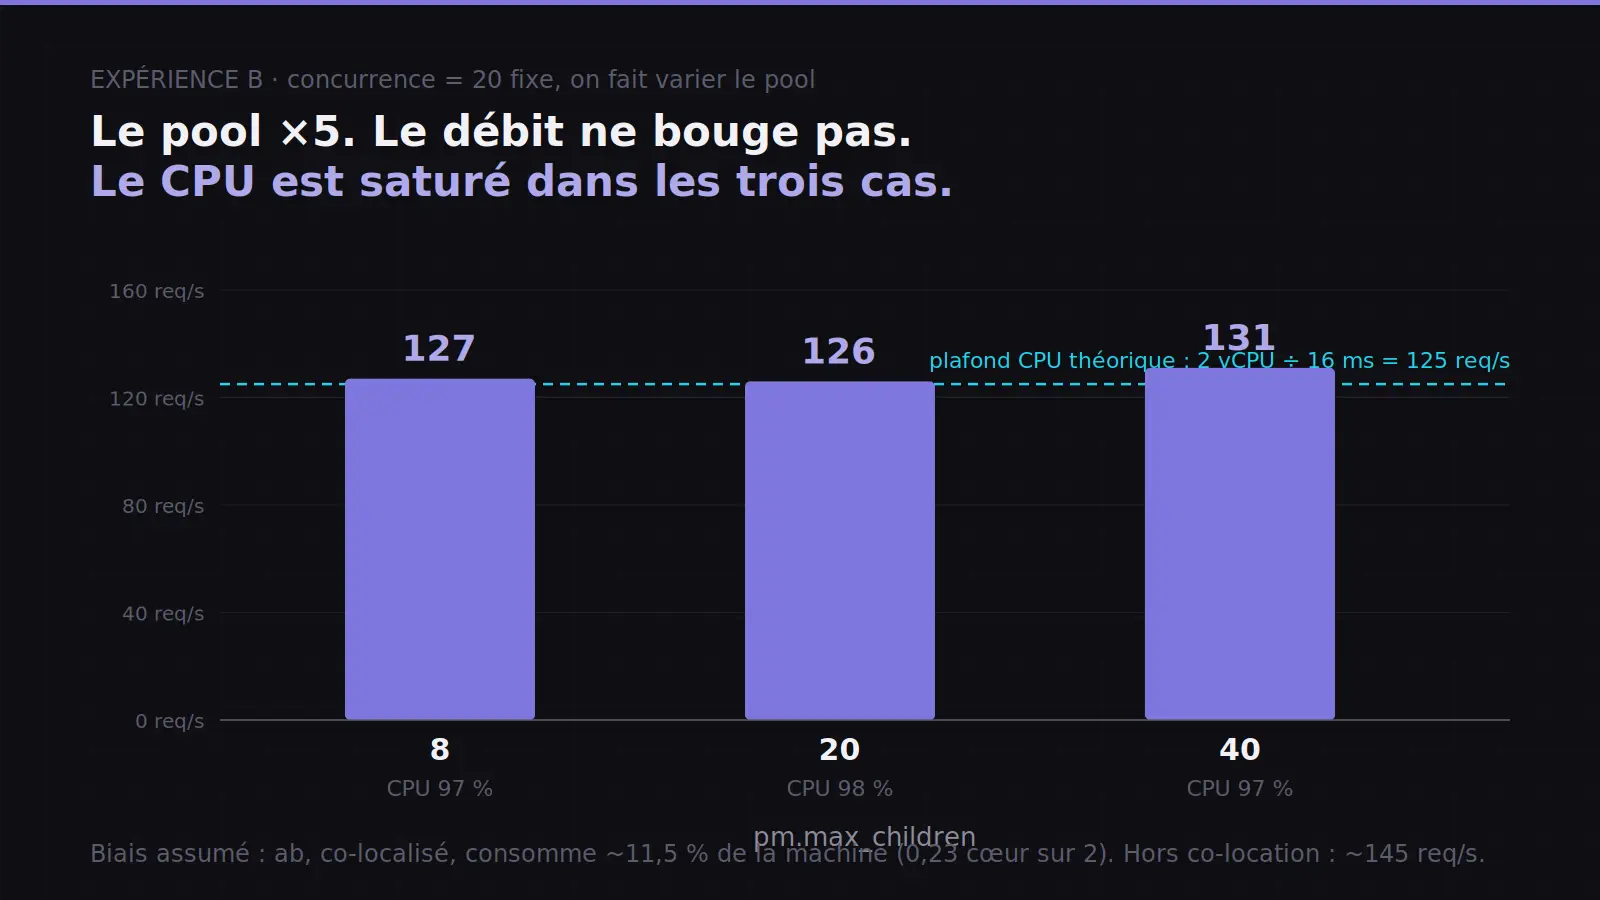
Le pool ×5, le débit plat, le CPU cloué à 97 %. Le mur n'a jamais été PHP-FPM.
Et le CPU est cloué à 97-98 % dans les trois cas.
Voilà. Le mur, c'est le CPU. Le plafond théorique calculé plus haut, 2 vCPU ÷ 16 ms ≈ 125 req/s, tombe sur le même ordre de grandeur que les 126-131 mesurés. Pas besoin d'aller chercher plus loin : la machine est CPU-bound.
pm.max_childrenne pilote pas le débit. Il pilote la profondeur de la file d'attente, donc ta latence, donc ta consommation mémoire. Pas ton throughput. À 8 workers comme à 40, mon serveur sort le même nombre de requêtes par seconde.
Ce que ces trois runs établissent :
pm.max_children×5 → débit plat. Ce paramètre ne contrôle pas le débit.CPU à 97-98 % sur les trois runs. C'est le mur.
Plafond théorique ≈ débit mesuré. La machine est CPU-bound.
Dans l'expérience A : p95 ×10 à débit constant. La concurrence ne fait que remplir la file.
Max_used_connectionsfigé à 26 en triplant la charge. MySQL n'est jamais le goulot.abconsomme ~11,5 % de la machine. Limite du protocole, assumée.
5. Alors où part vraiment le temps ?
Retour à la décomposition, avec ce qu'on sait maintenant.
Une requête = 16 ms
├── Boot de Laravel .............. 10,5 ms   (65 %)
├── Session, Eloquent, rendu .....  4,5 ms   (28 %)
└── Base de données ..............   ~1 ms   (6 %)
    ├── handshake ................  0,34 ms  (2 %)
    └── requête SQL ..............   ~0,6 ms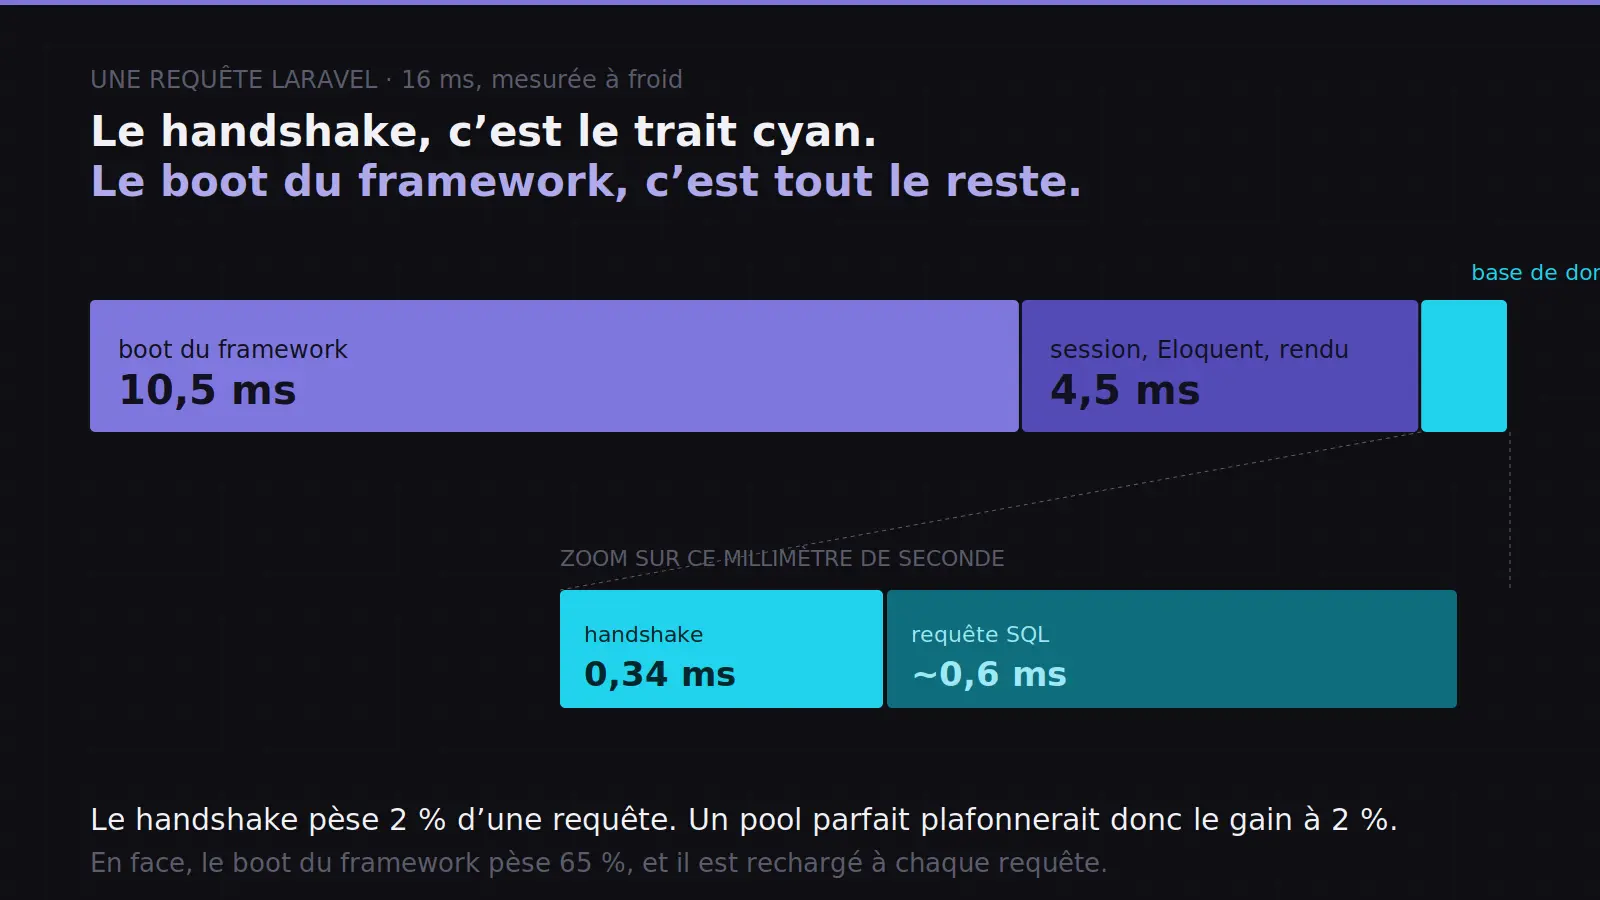
Le handshake, c'est le trait à droite. Le boot du framework, c'est tout le reste.
L'argument est purement arithmétique, et c'est ce qui le rend imbattable.
Le handshake pèse 2 % d'une requête. Donc l'éliminer, pool ou pas, plafonne le gain possible à 2 %. Ce n'est pas une estimation de ce qu'un pool m'apporterait, c'est le maximum théorique de ce qu'il pourrait m'apporter. Même un pool parfait, à coût zéro, qui supprimerait intégralement le handshake, ne me rendrait pas plus de 2 %.
En face, le boot de Laravel pèse 65 %. Rechargé intégralement, 104 810 fois. C'est ça qui brûle mes deux cœurs. C'est ça qui fixe mon plafond à ~127 req/s.
On s'obsède sur les 0,34 ms de la connexion, et pendant ce temps le stack en jette trente fois plus à redémarrer le framework à chaque requête.
La question « où est passé le pool de connexions en PHP ? » était mal posée depuis le début. Le pool n'est pas caché quelque part. Il est hors sujet. Il résoudrait un problème que je n'ai pas.
Et les fausses solutions, du coup ?PDO::ATTR_PERSISTENT, la connexion persistante qu'on te recommande en commentaire dès que tu parles de perf PHP ? Elle vise ces 2 %. Et en échange elle t'apporte des transactions non nettoyées entre requêtes, des locks orphelins, des variables de session qui traversent, et des bugs qui n'apparaissent qu'en production sous charge. Tu échanges 2 % de perfs, dans le meilleur des cas, contre une classe entière de bugs non déterministes. Ne fais pas ça.
6. Le seul endroit où le pool redevient une vraie question
Tout ce qui précède vaut pour ma machine, à ma charge. Il faut être honnête sur les limites.
Ma borne mémoire, d'abord. J'ai 5 pools FPM,pm.max_childrencumulé = 40, à ~39 Mo par worker. Quelqu'un qui voudrait « faire propre » en alignant les workers surmax_connections=151: 151 × 39 Mo = ~5,9 Go de PHP sur une machine de 8 Go. Le mur ne serait ni MySQL ni le CPU, ce serait l'OOM killer. Encore une preuve quemax_connectionsetpm.max_childrenne parlent pas de la même chose et ne se calibrent pas l'un sur l'autre.
Autre limite : mon thread cache.thread_cache_size = 9, pile au-dessus de mon pic historique de 8. Pendant mes tests de charge,Threads_createdest passé de 8 à 188: dès que la concurrence dépasse 9, le cache déborde et MySQL se remet à créer des threads. (C'est aussi pour ça que les chiffres de la section 3 ne sont pas rejouables tels quels : mes propres tests les ont modifiés.) Ma configuration n'est pas optimisée, elle est non saturée. C'est différent, et c'est une distinction que la plupart des articles de tuning ne font jamais.
Et le pool, alors ? Il redevient pertinent dès que le goulot se déplace :
Des centaines de workers, sur plusieurs machines, face à un
max_connectionsfini. Là, borner devient vital. C'est le rôle d'un vrai pool externe : ProxySQL, PgBouncer, RDS Proxy. Ils s'intercalent entre l'application et la base, maintiennent un pool réel côté serveur, et absorbent des milliers de connexions clientes derrière quelques dizaines de connexions vraies. C'est la solution correcte au problème que PHP-FPM ne peut pas résoudre lui-même.Une base distante. Mon handshake coûte 0,34 ms parce que MySQL est sur la même machine. Traverse un réseau, un VPC, une zone de disponibilité : le handshake passe à 5, 20, 50 ms. Il ne pèse alors plus 2 % mais l'essentiel du temps de réponse. Tous les conseils de cet article s'inversent.
Ce qui déplacerait mon plafond, en revanche, ce n'est pas un pool. C'est Octane (avec Swoole ou RoadRunner). Et pas parce qu'il apporte un pool de connexions : parce qu'il garde le framework chaud en mémoire entre les requêtes. Il me rend mes 10,5 ms de boot.
Combien ? Si on retire le boot, il reste ~5,5 ms → 2 vCPU ÷ 0,0055 = ~360 req/s. Soit environ 2 à 3×. Et c'est un calcul, pas une mesure: Octane ne supprime pas tout le boot (le middleware et le cycle de requête tournent toujours), et les 5,5 ms restants ne bougent pas. Je ne vais pas remplacer un chiffre non mesuré par un autre chiffre non mesuré. Le mesurer pour de vrai demande un environnement de staging, et je ne l'ai pas fait. Disons 2-3×, et c'est déjà énorme comparé aux 2 % du handshake.
Au passage : quand Octane te donne enfin un pool de connexions applicatif, c'est un effet de bord. Le processus survit, donc la connexion peut survivre. Le pool n'était pas la cause du gain, il était la conséquence d'un modèle d'exécution différent. C'est exactement ce qu'on avait établi en section 1 : le pool suppose un processus long-vivant. Toute la question était là depuis le début.
7. Ce qu'il faut retenir
Le conseil « utilise un pool de connexions » n'est pas faux. Il est incomplet. Ce qu'il devrait dire : si ton goulot est l'établissement des connexions, utilise un pool. La condition compte plus que le conseil.
Sur mon serveur, elle n'est pas remplie. Le handshake pèse 2 % d'une requête, donc un pool parfait me rendrait 2 % au maximum. Le goulot, c'est le CPU qui reboote Laravel 127 fois par seconde. Et je ne le déduis pas d'une intuition : j'ai multiplié le pool par 5, le débit n'a pas bougé, le CPU est resté à 97 %.
Ce que je retiens surtout, c'est la méthode. J'ai eu deux théories élégantes dans cet article, le thread cache de MySQL puispm.max_children, et les deux se sont écroulées au premier test sérieux. Toutes les deux étaient cohérentes. Toutes les deux collaient aux chiffres que j'avais. Il a fallu chercher le chiffre qui les contredisait pour voir qu'elles étaient fausses.
C'est le seul truc que je te recommanderais vraiment : mesure ton propre goulot avant d'appliquer le conseil de quelqu'un d'autre. Le tien n'est probablement pas là où tu le crois. Le mien ne l'était pas.
Prochain épisode. Dans cet article, j'ai calculé qu'Octane pourrait donner 2 à 3×. Calculé, pas mesuré — je l'ai dit en section 6. Une affirmation non testée, dans une collection qui promet de tester. Donc je vais la mesurer.
Toutes les mesures de cet article ont été prises sur mon VPS de production (2 vCPU, 8 Go, MySQL 8.0.46, PHP-FPM 8.4). Protocole, chiffres bruts et biais assumés en section 4. Si tu rejoues et que tu trouves autre chose, écris-moi.